「生成AIエンジニアのスキル」で検索すると、Python・LangChain・RAG…といった“身につけるべき技術リスト”が並びます。それは間違っていません。ただ2026年の現場では、リストを埋めた先で評価される軸が確実にずれ始めています。
キーワードは「自分で書けるか」ではなく「AIに任せて、その出力を正しく評価・統合できるか」。この記事は、必要スキルの暗記帳ではなく、現役エンジニアが“任せる側”に回るためのスキル設計図です。技術スタックを5層で棚卸しする地図、90日で積み上げる習得順序、独学・教材・資格の使い分け、そして身につけたスキルを「証明」する方法まで、1本にまとめました。
先に断っておくと、これは「未経験からAIエンジニアになる方法」の記事ではありません。すでにコードを書いて食べているエンジニアが、生成AIの普及で変わった評価軸に合わせて、いまの持ち技をどうアップデートするかに絞っています。Python・API・DB・テストといった既存スキルは学び直す対象ではなく、そのまま流用できる武器です。未経験からの学習全般はプログラミング独学ロードマップ、転職の段取りそのものはAIエンジニア転職ロードマップで別途整理しています。
結論:これからのスキルは「二階建て」で考える
最初に結論を置きます。2026年以降の生成AIエンジニアのスキルは、フラットなリストではなく二階建ての構造で捉えたほうが実務に効きます。
1階(土台スキル):Python・LLM/API・RAG・エージェント連携・LLMOpsなど「AIで作るための技術」。5つの層に分けて棚卸しでき、下の層ほど既存スキルが流用できる。ここは前提であり、差はつくが勝負どころではなくなりつつある。
2階(上位スキル):問題定義・仕様設計・出力評価・システム統合・責任の引き受けという「AIに任せて成果に変える技術」。2026年に市場価値が伸びているのはこちら。
土台をゼロにはできないが、土台“だけ”を厚くしても評価は頭打ちになる。1階は独学で最短ルートを通し、伸ばす比重を2階へ移す。そして両方を「動くもの+言語化」で証明する——これが今のスキル設計の芯です。
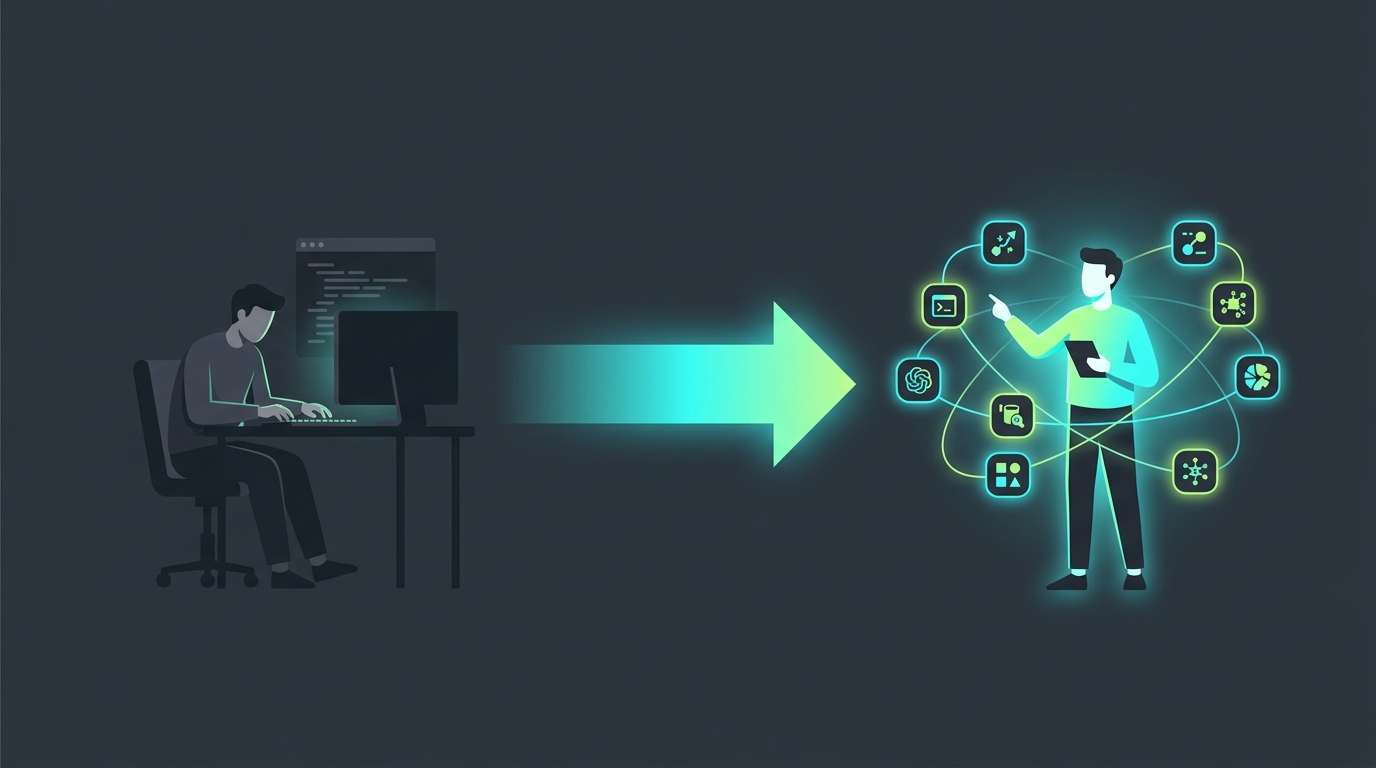
▲ 「コードを書く人」から「書くエージェントを設計・評価する人」へ。役割の重心が移動している
なぜ今スキルの定義が動いたのか:現場のデータ
感覚論で「AIで変わった」と言っても仕方がないので、数字から入ります。Anthropicが2026年に公開した「Agentic Coding Trends」系のレポートや各社の導入事例では、コーディングエージェントの実務浸透が明確に表れています。
Anthropicのレポートを読み解いた技術者の総括はシンプルで、エンジニアは「コードを書く人」から「設計して任せる人」へシフトしている、というものです。実装という戦術的な作業はAIが担い、人間の専門性は「解くに値する問題を定義すること」に集中していく、という構図です。
「AIで実装が減る=仕事が楽になる」ではありません。現場のエンジニアが口を揃えるのは、コードを書く時間が減った代わりに“評価コスト”が前面に出てきた、という感覚です。出力の良し悪しを判断し続け、前提を共有し、統合し、最終的な責任を引き受ける——この判断業務こそが新しいスキルの中身になります。
「じゃあエンジニアの仕事は減るのか」という不安には、採用データが別の答えを返しています。2025年の採用動向を分析した複数の調査では、AIコーディング普及後もエンジニア採用の落ち込みは他職能より浅く、採用全体に占める比率はむしろ上がっていると報告されています。減っているのは「言われた通りに実装するだけ」の工程で、増えているのは設計・判断・オーケストレーションを担える人材の需要です。市場価値の観点はAIエンジニアの年収は「オワコン論」では語れないでも触れています。
ここで効いてくるのが「現役エンジニアであること」です。生成AIの本番投入で詰まるのは、プロンプトの巧拙ではなく、システム統合・品質の再現性・コスト管理・責任ある運用といった、既存のソフトウェア開発で戦ってきた領域です。LLMのAPIを叩けるだけの人材は珍しくなくなりましたが、「LLMを既存システムに安全に組み込み、運用に乗せられる人材」はまだ多くありません。2026年の論点が「AIエージェントをどう本番運用するか」へ移ったことで、この差はさらに広がっています。
1階:土台スキルを「5層」で棚卸しする
まず土台から。1階の技術スキルは、下から上へ積み上がる5つの層(スキルスタック)として整理すると、何を流用し、何を新しく足すかがはっきりします。下の層ほど既存エンジニアスキルの流用が効き、上の層ほど2026年に差がつく新領域です。
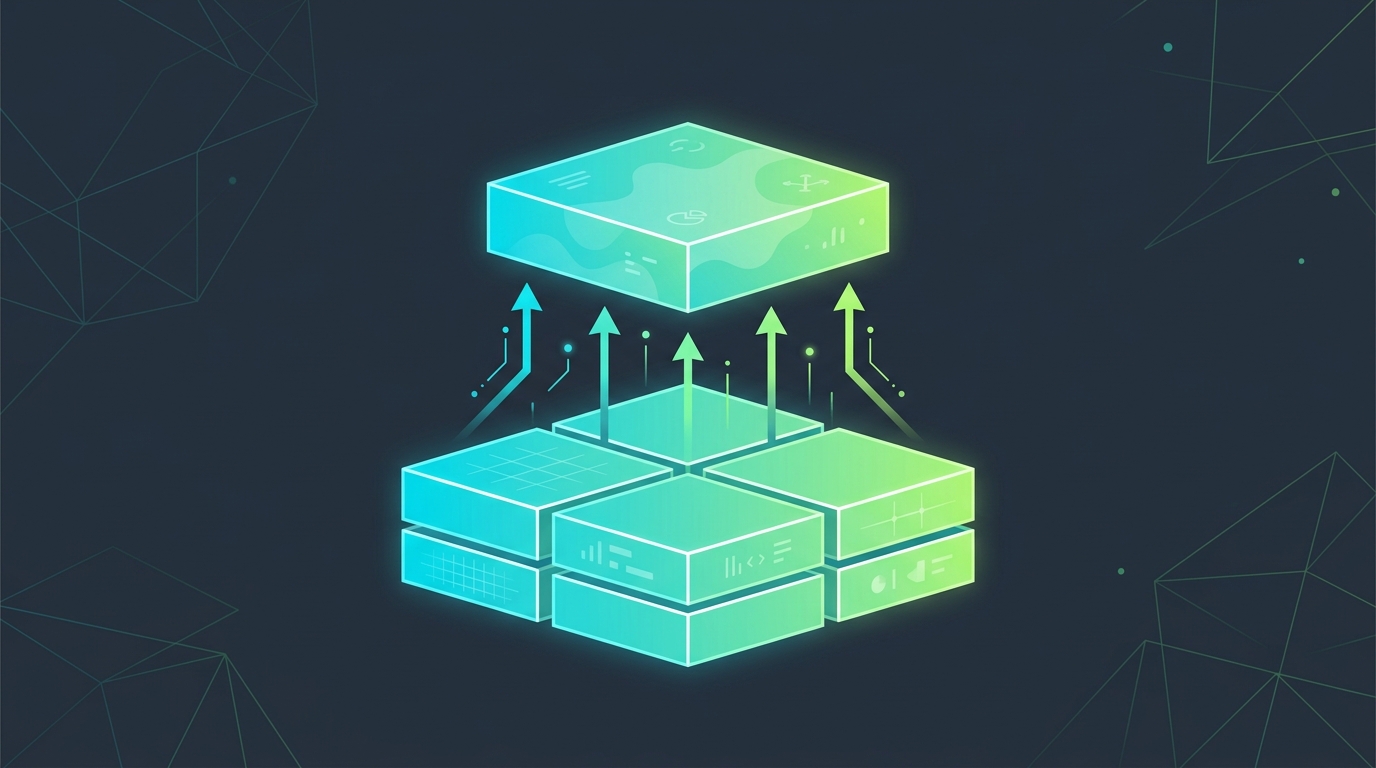
▲ 土台スキル(広い基盤)が上位スキル(判断力)を支える。伸ばす比重は上へ
| 層 | 中身 | 現役エンジニアにとっての位置づけ |
|---|---|---|
| Layer 4 評価・運用(LLMOps) | ハルシネーション対策・出力評価(Eval)・ガードレール・コスト/レイテンシ最適化 | 本番に乗せる層。語れる人が少なく、ここを語れると上級扱い。2階の「出力評価」と直結 |
| Layer 3 エージェント & MCP | ツール呼び出し・複数ステップの自律実行・MCPによる外部システム連携 | 2026年の最前線。統合・権限管理の経験が最も効く |
| Layer 2 RAG | 埋め込み・ベクトルDB・チャンキング・再ランキング | 求人で最も問われる実装スキル。本腰を入れるのはここから |
| Layer 1 LLMを叩く基礎 | LLM API(OpenAI / Anthropic / Google)・プロンプト設計・構造化出力・トークン/コスト感覚 | 最初の足場。現役エンジニアなら短期間で通過できる |
| Layer 0 既存スキル | Python・API設計・DB・非同期処理・テスト・CI/CD | 学び直しではなく“流用”する土台。最大の武器 |
多くの入門記事はLayer 0〜1に紙幅の大半を割きますが、現役エンジニアにとっての本丸はLayer 2以上です。以下、層ごとに「何を足すか」を絞って見ていきます。
Layer 0:既存スキルの棚卸し(流用・新規・深追い不要)
最初にやるべきは新しい勉強ではなく、持ち物の棚卸しです。生成AI開発は「まったく新しい技術」に見えて、土台の多くは普通のソフトウェア開発と地続きです。
| あなたの既存スキル | 生成AI開発での扱い | 判定 |
|---|---|---|
| Python / API実装 | そのまま主戦場。生成AIライブラリの大半がPython中心 | そのまま流用 |
| REST/API設計・認証 | LLM APIの呼び出し・レート制御・リトライ設計に直結 | そのまま流用 |
| DB・SQL | ベクトルDBの概念理解が速い。メタデータ設計の勘が効く | そのまま流用 |
| 非同期・ストリーミング処理 | トークンのストリーミング表示や並列呼び出しで頻出 | そのまま流用 |
| テスト・CI/CD・監視 | LLMOps(評価・回帰検知)の土台になる | そのまま流用 |
| プロンプト設計 | 新領域だが習得は速い。“職人技”より再現性が重要 | 新しく習得 |
| 埋め込み・ベクトル検索 | RAGの中核。概念は新しいがDB経験で吸収しやすい | 新しく習得 |
| 機械学習の数学・モデル学習 | LLMを“利用”する側では深追い不要。概念理解で十分 | 深追い不要 |
重要なのは最後の「深追い不要」です。多くの入門記事が「線形代数を」「Transformerを論文で」と煽りますが、生成AIを使ってプロダクトを作る側に回るなら、トランスフォーマー/Attentionの仕組みは「なぜ長文で精度が落ちるのか」「なぜもっともらしい誤りを出すのか」を説明できる程度の概念理解で足ります。確率・統計・線形代数も基礎で可。モデルを自前で学習させるML研究寄りの職種と、LLMを組み込むアプリケーションエンジニアは別職種だと割り切りましょう。
Layer 1:LLMを“本番品質で”叩く
最初の足場は、LLMをコードから安定して呼び出せることです。ポイントは「動かす」ことではなく、後段のシステムに渡せる品質で叩くことです。
- LLM APIの呼び分け:OpenAI / Anthropic(Claude)/ Google の各APIを使い、料金体系・コンテキスト長・得意分野の違いを体感する
- 構造化出力:自由テキストではなくJSON Schemaやツール呼び出し(関数呼び出し)で「壊れない出力」を取り出す。後段に渡すなら必須
- プロンプト設計の再現性:一発勝負の“呪文”ではなく、役割指定・出力スキーマ・few-shot・検証をテンプレート化し、コードのようにテストできる形にする。ここが「プロンプト職人」と「エンジニア」の分岐点
- トークン/コスト感覚:1リクエストあたりのコストと、コンテキストをどう削るか。従量課金なので処理量から見積もれる
ここで止まってしまう人が一番多いのですが、「ChatGPTを業務で使える」レベルと「LLMを組み込んだ機能を出荷できる」レベルの間には深い谷があります。その谷を埋めるのがLayer 2以降です。
Layer 2:RAG(求人で最も問われる層)
RAG(Retrieval-Augmented Generation/検索拡張生成)は、LLMの弱点である「学習データにない情報には答えられない」問題を、外部データを検索して文脈に注入することで補う手法です。社内ドキュメントQA、サポート自動化、社内ナレッジ検索など、業務システム連携の案件の多くがここに紐づきます。
- 埋め込み(Embedding):テキストをベクトル化して「意味の近さ」で検索する。検索=完全一致ではない、という発想の転換
- ベクトルDB:Chroma・Weaviate・Pinecone・pgvector などを実際に動かす。DB経験があれば概念の吸収は速い
- チャンキング設計:長文をどう分割するかで精度が大きく変わる。“地味だが効く”実務の勘所
- 再ランキング・ハイブリッド検索:ベクトル検索だけで拾えない精度を、キーワード検索や再ランクで補う
- フレームワーク:LangChain / LlamaIndex でパイプラインを組む。求人票で名指しされることが多い
① LangChain か LlamaIndex の公式チュートリアルでRAGを一周する → ② 題材を「自分が詳しいドメインの実データ」(社内Wikiの抜粋、自分のブログ全文など)に差し替えて作り直す → ③ 精度が悪い質問を集め、チャンキング/再ランクで改善し、その過程をREADMEに残す。ゴールは「動いた」ではなく「なぜ精度が上がったかを語れる」状態です。実データで動かした瞬間にチャンキングや精度の現実的な問題が一気に見え、それがそのまま面接で語れる材料になります。
Layer 3:AIエージェントとMCP
AIエージェントは、LLMが「考える→ツールを呼ぶ→結果を見てまた考える」というループを自律的に回し、複数ステップのタスクを実行する仕組みです。単発の質問応答から、業務プロセスの自動実行へと用途が広がりました。そこで外部システムとの接続規格として広く採用されているのが、Anthropicが2024年11月にオープン規格として公開したMCP(Model Context Protocol)です。
| 用語 | 役割 | ざっくり言うと |
|---|---|---|
| Agent | 自律的にツールを使ってタスクを遂行する主体 | 「考えて動く」本体 |
| MCP | エージェントと外部システム・データをつなぐ共通規格 | システム連携の“USB端子” |
| Tool / Function | エージェントが呼び出せる個別の機能 | エージェントの“手” |
| Skills | 特定の作業手順をエージェントに渡す手順書 | “やり方マニュアル” |
現役エンジニアにとって朗報なのは、ここでこそ既存スキルが最大の武器になることです。エージェントを業務に乗せる作業は、結局のところAPI連携・権限管理・エラーハンドリング・冪等性の設計です。「AIに既存システムを触らせる」とは統合とガバナンスの問題であり、未経験者が一番苦戦し、現役エンジニアが一番得意とする領域です。学習は小さく始めるのが正解で、まずツールを1つだけ持たせた最小のエージェントで自律ループが回る感覚を掴み、MCPで外部連携を1本通してから連携先を増やしていきます。
Layer 4:評価・運用(LLMOps)
デモは動くのに本番で炎上する——その差を埋めるのがこの層です。
- ハルシネーション対策:根拠(出典)を併記させる、RAGで接地する、検証ステップを挟む。「もっともらしい誤り」をどう減らすか
- 出力評価(Eval):プロンプトやモデルを変えたら品質が上がったのか下がったのか、テストのように回帰検知する。CI/CDの経験がそのまま効く
- ガードレール:禁止トピック・個人情報・プロンプトインジェクションへの防御。セキュリティの発想が必要
- コスト/レイテンシ最適化:モデルの使い分け、キャッシュ、コンテキスト圧縮
この層は、テスト・監視・SREの経験があるエンジニアが有利です。「LLMの出力をどう継続的に品質保証するか」は、ソフトウェア工学の問いそのものだからです。そしてLayer 4は、次に説明する2階の「出力評価・レビュー力」と地続きです。1階の最上段が、2階への階段になっていると捉えてください。
1階は「AIと会話できる程度」まででいい
重要なのは、これらを「暗記して自力実装できる」までやり込む必要は薄れているという点です。生成AI自身が実装を出してくれる以上、土台スキルの役割は「AIの出力を疑い、評価し、修正指示を出せる程度に仕組みを理解していること」へ変わりました。トランスフォーマーの数式を暗唱できることより、「なぜこのRAGは的外れな回答をするのか」を切り分けられるほうが実務では効きます。
とはいえ、土台がスカスカだとAIの出力を評価できません。体系立てて土台を組み直したい人は、学習設計から入るのが結局は近道です。
独学で止まりがちな生成AIの基礎を、体系立てて学べる講座・スクールを比較検討できます。無料カウンセリングで現状のスキルギャップを診断してもらうのも手です。
スクールを比較する2階:市場が評価する「任せる技術」5つ
ここが本題です。土台の上に積む「AIに任せて成果に変える」上位スキルを、実務の流れに沿って5つに分解します。プロンプトの上手さは、この5つの一部でしかありません。
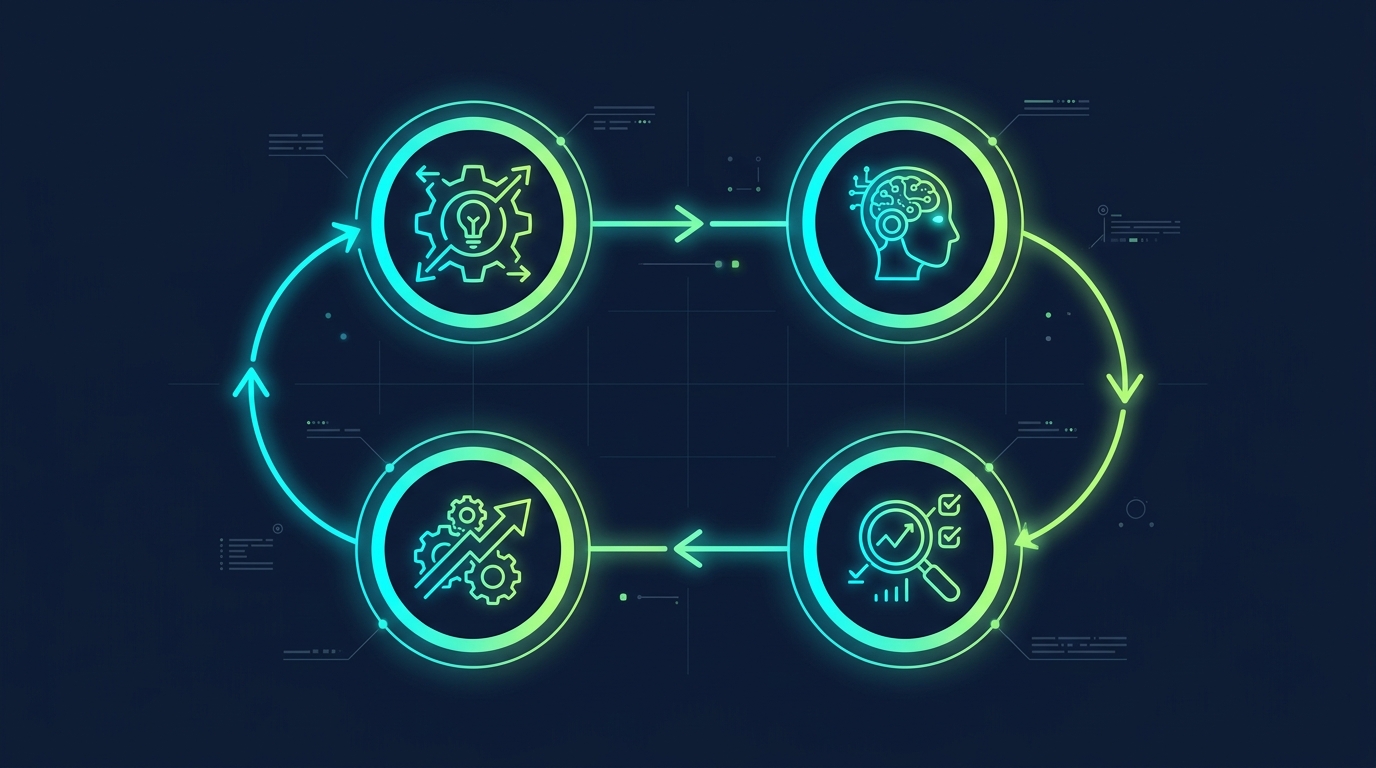
▲ 計画→委任→評価→統合のループを回す。各段に対応する上位スキルがある
-
① 問題定義力(何を作るべきかを決める)
AIは「どう作るか」は得意でも「何を作るべきか」は決められません。曖昧な要望を、解くに値する問題へ翻訳する力が最上流の価値になります。これが弱いと、AIが高速に“間違ったもの”を量産します。
-
② 仕様設計・コンテキスト設計力
エージェントに渡す仕様・制約・前提の設計。いわゆる仕様駆動開発です。AIの出力品質は、渡したコンテキストの質でほぼ決まります。プロジェクトの背景をどう構造化して渡すかが、そのまま成果物の質になります。Layer 1の「再現可能なプロンプト設計」はこのスキルの一部です。
-
③ 出力評価・レビュー力
生成されたコードの正しさ・安全性・保守性を判断し続ける力。前述の「評価コスト」の正体です。テスト設計、セキュリティ観点、アーキ整合性の検証——ここを人間が担保できないと、AIの速度はそのまま負債の速度になります。Layer 4のEval・ガードレールの考え方がそのまま効きます。
-
④ 統合・オーケストレーション力
複数エージェントやツールの出力を、既存システムへ矛盾なく組み込む力。1つのツールに全部任せるのではなく、作業スタイルに合わせて使い分け、段階的に権限を委ねる設計判断が問われます。Layer 3のMCP・権限設計の経験が土台になります。
-
⑤ 責任を引き受ける力
最終的に「このコードで問題ない」と判断し署名する役割。AIは責任を取れません。意思決定とリスク管理は、むしろ人間側に濃く残る領域であり、シニアであるほど比重が上がります。
この5つを眺めると気づくはずです。どれも従来の“良いエンジニアリング”そのものだということに。生成AIは新しいスキルを要求したのではなく、これまで実装作業に埋もれて見えにくかった設計・評価・判断の価値を、前面に押し出したのです。エージェント開発の実践論として語られる「Agentic Engineering(設計して任せる開発)」が、いまのスイートスポットだと言われる理由もここにあります。
生成AI・LLMを使った開発案件は、単価も裁量も大きい傾向があります。まずは無料登録して、いまの自分のスキルでどんな案件・単価が狙えるかを見てみるのがおすすめです。
「プロンプトが上手い=スキルがある」ではない
ここで一つ、キャリアを誤らせやすい誤解を潰しておきます。生成AIブームの初期は「プロンプトエンジニアリング」が花形スキルのように語られました。しかし2026年の現場では、プロンプトの巧拙は上記②の一部にすぎません。
単なるプロンプト作成者ではなく、システム設計能力とビジネス実装力を掛け合わせられる人材へ——というのが求人側の一致した要求です。よく言われるのが「AI理論・実装力 × エンジニアリング力 × ビジネス・デザイン力」のハイブリッドという整理で、これは二階建てモデルの2階を別角度から言い換えたものです。
「プロンプトのテクニック集」を集めることに時間を使うより、自分のレビューが通ったPRの割合、任せた実装を統合しきった件数のような“任せて成果に変えた実績”を積むほうが、市場価値に直結します。ポートフォリオに書くべきは「使ったツール」ではなく「AIに任せて何を成立させたか」です。
独学で伸びる8割、現場でしか伸びない2割
「生成AIのスキルは独学できるのか」への現実的な答えは、1階の大部分は独学で伸びる。2階と運用の一部は、現場かそれに準ずる実戦が要る、です。ここを混同すると、独学で伸ばせる部分まで「スクールに行かないと無理」と諦めたり、逆に現場でしか付かない感覚を独学で延々と追いかけて消耗したりします。
| 区分 | 具体スキル | 伸ばし方 |
|---|---|---|
| ◎ 独学で十分伸びる | Python・主要ライブラリ、LLM APIの呼び出し、プロンプト設計、RAGの実装、ベクトルDBの基礎、エージェント/ツール連携の試作(Layer 0〜3) | 公式ドキュメントとチュートリアルが充実しており、手元で完結する |
| △ 現場/実戦で伸びる | 本番運用での評価設計(LLMOps)、コスト・レイテンシ最適化、ハルシネーション対策の運用判断、機密データの扱い、要件のすり合わせ、2階の「統合」「責任」 | 規模と責任が伴って初めて身につく。業務で半歩踏み出すか、実戦に近い課題で代替する |
この仕分けの実利は、独学パートは独学に全振りし、現場パートは業務で埋めると決められることです。現役エンジニアの最大の強みは、今の業務に生成AIを差し込める“現場アクセス権”を持っていること。独学で1階を固め、現場の小さなタスクで2階を育てる——これが最短ルートになります。
数学・線形代数・確率統計を「完璧にしてから」始めようとする人が一定数います。生成AIのアプリケーション層(API・RAG・エージェント)に進むなら、数学は“必要になった都度”で十分間に合います。モデルをゼロから研究・学習させる職種を目指す場合のみ、先に厚く積みましょう。
1階の習得順序:90日で積み直すロードマップ
順序が9割です。5層を、現役エンジニアが業務と並行して積み上げる順序に落とし込みます。フルタイム学習ではなく「平日1時間+週末」程度を想定し、各段で“動くミニ成果物を1つ作る”ことをゴールにすると、知識がスキルに変わります。
-
Week 1–2|Layer 0–1:APIを本番品質で叩く
既存スキルの棚卸しを済ませ、「深追いしない範囲」を決める。OpenAI / Claude / Gemini を呼び分け、構造化出力でJSONを取り出すところまで。別言語が本業の人も、Pythonは“学ぶ”より“思い出す”に近い。成果物:CLIでLLMに質問を投げ、返答をJSONに整形するツール
-
Week 3–6|Layer 2:RAGを“自分のデータ”で作る
LangChain / LlamaIndex のチュートリアルを一周し、自分の実データで作り直す。チャンキングと再ランクで精度を改善し、出典提示まで触る。その過程をGitHubに残す。ここが最重要。成果物:自分の資料に質問できる小さなナレッジQA
-
Week 7–10|Layer 3:エージェント & MCPを小さく自作
ツール1つの最小エージェントから始め、自律ループを体感。MCPで外部システム連携を1本通す。深追いより“動かした経験”が先。成果物:外部APIを使って多段タスクをこなす簡易エージェント
-
Week 11–13|Layer 4+言語化:運用視点を足し、語れる状態にする
評価(Eval)・ハルシネーション対策・コスト最適化を作品に組み込む。面接で「なぜその設計か」を語れるよう言語化する。成果物:評価の仕組みと設計判断をREADMEに書いたポートフォリオ
このロードマップの肝は、Week 3以降に時間を集中させることです。入門記事の多くが前半(基礎)を厚くしますが、現役エンジニアが市場価値を上げるのはLayer 2〜4。前半を駆け足で抜け、RAGとエージェントに最大の時間を投資してください。「どの層から手をつけるか」で迷ったら、答えはRAGです。求人で問われやすく、ポートフォリオに直結し、その後のエージェントにもつながります。
2026年の前提:学習そのものをAIと“並走”する
2026年の独学は、GitHub Copilot・Claude・ChatGPTなどを並走者にするのが標準です。コードを書かせ、エラーを説明させ、設計のレビューをさせながら学ぶ。これは2階の「任せる技術」の予行演習でもあります。ただしAIが出したコードを読めない・直せないなら、それは身についていない。並走は加速装置であって、理解の代替ではありません。開発での具体的な使い方はエンジニアのためのAIコーディング活用術でも扱っています。
2階の育て方:業務に埋め込む3ステップ
1階は学習で積めますが、2階はまとまった学習時間では育ちません。だからこそ、スキル更新はいまの業務の中に埋め込むのが唯一続く方法です。新しい勉強を足すのではなく、既存の作業の“やり方”を差し替えます。
-
Step 1:まず1タスク、丸ごとAIに委任してみる
小さめの実装タスクを1つ選び、自分で書かずにエージェントへ仕様を渡して任せる。目的は成果物より「評価する側の視点」を体で覚えること。出力のどこを疑い、どう直したかをメモに残します。
-
Step 2:レビュー観点をチェックリスト化する
AI生成コードに対して自分が指摘した点(テスト漏れ・セキュリティ・命名・アーキ逸脱)を蓄積し、自分専用のレビュー基準に育てる。これがそのまま上位スキル③の資産になります。
-
Step 3:仕様・前提の“渡し方”を型にする
プロジェクトの背景・制約をどう構造化してエージェントに渡すと精度が上がるかを試行し、テンプレ化する。コンテキスト設計(②)が安定すると、任せられる範囲が一気に広がります。
この3ステップは、どれも「新しい教材を買う」必要がありません。今日の業務でそのまま始められます。
教材の選び方:無料・サブスク・スクールの損益分岐
教材選びは「良し悪し」ではなく「自分の時間単価との損益分岐」で決めます。生成AIアプリケーション層の情報は、無料の公式ドキュメント(各LLMプロバイダのAPIリファレンスやクックブック、Hugging Face、LangChain / LlamaIndexのドキュメント)が一次情報として最も濃く、まずはここで走れます。
| 選択肢 | 向いている人 | 注意点 |
|---|---|---|
| 無料リソース 公式Doc・クックブック・OSS | 自走できる現役エンジニア。一次情報を読み解ける人 | 順序を自分で設計する必要がある。体系化は自前 |
| サブスク 学習動画・演習プラットフォーム | 体系立てて最短で通したい人。手を動かす演習が欲しい人 | “視聴で満足”しがち。作る時間を必ず確保する |
| スクール メンター付き講座 | 強制力・添削・転職サポートに価値を感じる人 | 費用が大きい。独学で伸びる1階に払い過ぎていないかを確認 |
現役エンジニアへの現実解は、まず無料+サブスクで3ヶ月走り、損益分岐を実測してから判断することです。3ヶ月でRAGの試作まで到達できたなら、スクール費用の多くは不要かもしれません。逆に「時間が取れず数週間で止まった」なら、強制力にお金を払う価値があります。判断軸は「自分でカリキュラムを組める自信があるか」。いきなり高額な講座に申し込む前に、自分が独学でどこまで走れるかを先に測る——これが一番のコスト最適化です。スクールを検討する場合は、先ほどの比較CTAから候補を並べてみてください。
資格は要る?生成AIパスポート・G検定・E資格の使いどころ
結論から言うと、エンジニアにとって資格は「スキルの証明」ではなく「学習の足場」「土台知識の網羅性チェック」として使うのが正解です。上位スキル(2階)は資格では測れず、採用側が見たいのは「AIに任せて何を成立させたか」の実績です。一方で、独学の抜け漏れを潰す目的なら有効です。
| 資格 | 主催 / 位置づけ | エンジニアでの使いどころ |
|---|---|---|
| 生成AIパスポート | GUGA(生成AI活用普及協会)/生成AIの基礎知識とリスク・リテラシー | 用語と安全な使い方の整理。エンジニアには物足りないが“抜け確認”には使える |
| G検定 | JDLA(日本ディープラーニング協会)/ディープラーニングを活用するジェネラリスト向け | AI全体の地図を短期間で頭に入れる土台づくり。非実装の概念整理に向く |
| E資格 | JDLA/ディープラーニングを実装するエンジニア向け。JDLA認定プログラムの修了が受験条件 | 実装理論まで深く固めたい人、モデル寄りに進みたい人向け。受験前提のコストが大きく、目的を選ぶ |
アプリケーション層を目指す現役エンジニアなら、資格は“任意”です。土台に不安があればG検定で全体像を整理し、それ以外は手を動かす時間に回すほうが費用対効果で勝ります。優先順位は「動くRAG/エージェントの作品 > 資格」。資格は入口の信頼、実績が評価の本体です。クラウド系資格との付き合い方はAWS資格はエンジニアに必要かも参考になります。
最大の盲点:スキルを「証明」する技術
スキルは「身につけた」だけでは市場で評価されません。「示せる」状態にして初めて価値になります。生成AI領域はまだ新しく、職務経歴で具体的な実績を示せる人は多くない。だからこそ証明できる人が一気に抜けます。
- 動くもの:RAGやエージェントの小さなアプリを1つデプロイし、触れる状態にする。完成度より「自分で組んだ」事実が効く
- 読めるコード:GitHubにREADME付きで公開。なぜその設計にしたか(チャンク戦略・モデル選定・評価方法)をREADMEに書く
- 意思決定の言語化:「なぜRAGにしたか」「ハルシネーションをどう抑えたか」「AIに何を任せ、どこを自分でレビューしたか」を口頭で説明できる。技術面接で最も差がつくのはここ
3つ目の言語化は軽視されがちですが、生成AIの実務は“正解のない選択の連続”です。だから採用側は完成品より判断のプロセスを見ます。これは2階の「問題定義」「評価」「責任」をそのまま言葉にする作業でもあります。現職で任せた実装の件数やレビュー基準といった業務上の実績も、同じ枠組みで語れるように整理しておきましょう。ポートフォリオの作り方はエンジニアのポートフォリオ作り方ガイド、言語化の鍛え方は技術面接対策の完全ロードマップで詳しく扱っています。
証明が揃うと、転職市場での見え方が変わります。生成AI領域は求人側もスキルの言語が固まりきっておらず、「何を作れるか」「何を任せて成立させたか」を具体物で示せる人ほど話が早い。到達したい年収から逆算したい場合はAIエンジニアの年収を職種×スキル層で設計するを合わせて読むと、スキルとキャリアが線でつながります。
「任せて成果に変える」経験は、いまの市場で最も評価されるスキルの一つです。AI・LLM領域に強い転職エージェントに相談すれば、自分の実績がどの年収帯で通用するかを客観的に把握できます。
続けるための“週10時間”運用設計
独学が頓挫する原因の大半は「意志が弱い」ではなく設計の問題です。業務と並行する現役エンジニアが確保できるのは、現実的には週8〜10時間程度でしょう。この制約を前提に、続く仕組みを組みます。
- インプット3:アウトプット7。動画や記事を見る時間より、作る時間を必ず多く取る。手が止まったらインプット過多のサイン
- “1ステップ=1成果物”でしか進めない。理解度ではなく「動くものができたか」を進捗の単位にする
- 週次で1テーマにコミット。今週はRAG、と決めたら他に浮気しない。新ツールは“来週のメモ”に退避
- AI並走で詰まり時間を減らす。30分悩んだらAIに説明させ、なぜそうなるかを自分の言葉で確認して進む
新しいモデルやツールが毎週のように出るため、追いかけるだけで満足してしまう“トレンド消費”に陥りがちです。キャッチアップは「作る手」を止めない範囲で。土台(API・RAG・エージェントの型)は変わりにくく、ここを固めた人ほど新ツールへの適応も速くなります。「最短◯日」の数字に振り回されず、止まらない設計を優先してください。
よくある質問(FAQ)
30代・未経験からでも生成AIエンジニアになれますか?
可能性はありますが、この記事の主眼とは別軸です。未経験の場合はまず1階の土台スキルを固める学習設計が先になります。ただし、既になんらかの開発経験があるなら、その経験は「評価・統合」という2階のスキルに直結する強みになります。年齢そのものより「任せて成果に変えた実績を語れるか」が評価を分けます。
生成AIでエンジニアの仕事はなくなりますか?
「実装だけをこなす工程」は縮小しますが、2025年以降の採用データではエンジニア需要はむしろ底堅く、比率は上昇傾向です。なくなるのは職種ではなく、AIに置き換え可能な“作業”です。設計・評価・判断へ重心を移せる人ほど需要は増えます。
独学だけで上位スキルまで到達できますか?
土台スキルは独学で十分伸ばせますが、上位スキル(特に評価・統合・責任)は実際のプロジェクトで“任される経験”がないと育ちにくい領域です。独学の限界と補い方は、本記事の「独学で伸びる8割、現場でしか伸びない2割」と「2階の育て方」で整理しています。
資格は取るべきですか?
土台スキルの証明としては有効ですが、上位スキルは資格で測れません。採用側が見たいのは「AIに任せて何を成立させたか」の実績です。資格は入口の信頼、実績が評価の本体、という優先順位で考えると失敗しにくいです。
機械学習や数学はどこまで必要ですか?
LLMを利用してプロダクトを作る側なら、線形代数や確率統計を深く学ぶ必要はありません。「埋め込みとは意味のベクトル化」「Attentionが長文で効きにくくなる理由」といった概念レベルで十分です。モデルを自前で学習・ファインチューニングする領域に進む場合のみ、数学の比重が上がります。
どの層から手をつけるべきですか?
既にコードを書けるなら、Layer 0〜1は確認程度で抜け、Layer 2(RAG)から本腰を入れてください。求人で問われやすく、ポートフォリオに直結し、その後のエージェント(Layer 3)にもつながります。並行して、業務で1タスクをAIに任せる「2階の練習」も始めておくと効率的です。
スクールは必要ですか?
現役エンジニアなら1階の大部分は独学で到達できます。判断軸は「自分でカリキュラムを組める自信があるか」。まず無料リソースとサブスクで3ヶ月走ってみて、手が止まったら強制力・添削に価値のある講座を検討する、という順番がコスト面で合理的です。
まとめ:スキルリストの“先”に立つ
「生成AIエンジニアのスキル」を検索リストの暗記で終わらせると、AIが最も得意な領域で正面から競うことになります。2026年に評価が伸びているのは、その反対側——AIに実装を渡し、問題を定義し、出力を評価し、システムへ統合し、最後に責任を引き受けるという二階建ての2階部分です。
・1階の技術スキルは5層で棚卸しする。Python・API・DB・テストなどLayer 0の既存スキルはそのまま流用できる武器
・本腰を入れるのはLayer 2(RAG)→ Layer 3(エージェント/MCP)→ Layer 4(LLMOps)。90日なら後半に時間を集中させる
・1階の大部分は独学で伸びる。2階(問題定義・仕様設計・評価・統合・責任)は業務にAIを委任することでしか育たない
・教材は損益分岐で選び、資格は証明ではなく足場として使う
・スキルは「動くもの+読めるコード+意思決定の言語化」で証明して初めて市場価値になる
土台スキルは「AIと会話できる程度」まで最短で。伸ばす時間の比重は上位スキルへ。そして上位スキルは、教材ではなくいまの業務にAIを委任することでしか育ちません。今日のタスクを1つ、AIに任せてみるところから、あなたのスキル定義を更新していってください。

フリーランスAIエンジニア。AIパイプライン開発と技術キャリアについて発信しています。